Domain red-herring.de kaufen?
Wir ziehen mit dem Projekt
red-herring.de um.
Sind Sie am Kauf der Domain
red-herring.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain red-herring.de kaufen?
Was bedeutet "Edu Video Privacy" in der App Prezi?
"Edu Video Privacy" ist eine Funktion in der App Prezi, die es Benutzern ermöglicht, die Privatsphäre ihrer Videos zu schützen. Mit dieser Funktion können Benutzer ihre Videos auf privat setzen, sodass sie nur von ausgewählten Personen angesehen werden können. Dadurch wird sichergestellt, dass die Inhalte nur für den vorgesehenen Zweck verwendet werden und nicht öffentlich zugänglich sind. **
Wie wird "privacy" ausgesprochen?
"Privacy" wird auf Englisch wie "pry-vuh-see" ausgesprochen. **


Ähnliche Suchbegriffe für Data-Privacy-in-der
Top-Angebote
Produkte zum Begriff Data-Privacy-in-der:
-
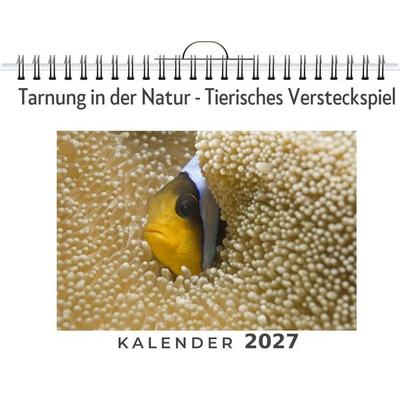
Tarnung in der Natur - Tierisches VersteckspielEntdecken Sie Die Faszinierende Welt Der Tarnung In Der Natur Mit Unserem Einzigartigen Wandkalender 'tierisches Versteckspiel'! Monat Für Monat Enthüllen 12 Atemberaubende Motive, Wie Sich Tiere Meisterhaft In Ihrer Umgebung Verbergen - Ein Wahres...19,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Red Hat Data GridRed Hat Data Grid – In-Memory-Datenspeicher für schnelle und skalierbare Anwendungen Red Hat Data Grid ist eine professionelle Red Hat Subskriptionslösung für Unternehmen, die Daten schneller bereitstellen, Anwendungen performanter machen und verteilte Datenzugriffe strukturierter organisieren möchten. Die Lösung eignet sich besonders für moderne Unternehmensanwendungen, bei denen häufig genutzte Daten mit möglichst geringer Latenz verfügbar sein sollen. Wenn Sie diese Lösung über unsere Plattform kaufen , erhalten Sie eine offizielle Red Hat Subskription für den vorgesehenen Nutzungsumfang. Ihre Bestellung wird über unsere sichere Zahlung verarbeitet und anschließend digital bereitgestellt. Wenn Sie weitere Red Hat Lösungen für Middleware, OpenShift, Linux, Integration oder Enterprise-Infrastruktur suchen, können Sie passende Produkte ebenfalls direkt bei uns im Shop für Red Hat kaufen . Der genaue Preis richtet sich nach dem gewählten Subskriptionsumfang, der gewünschten Laufzeit und dem konkreten Einsatzszenario. Die Lösung richtet sich an IT-Abteilungen, Entwicklungsteams, Plattformverantwortliche und Unternehmen, die datenintensive Anwendungen zuverlässiger und reaktionsschneller betreiben möchten. Red Hat Data Grid kann dabei helfen, häufig benötigte Daten näher an Anwendungen bereitzustellen und damit Zugriffe auf langsamere Backend-Systeme zu reduzieren. Dadurch eignet sich die Lösung für Szenarien, in denen Performance, Skalierbarkeit und Datenverfügbarkeit eine wichtige Rolle spielen. Schneller Zugriff auf häufig genutzte Daten Red Hat Data Grid ist für Unternehmen interessant, die ihre Anwendungen durch einen leistungsfähigen In-Memory-Datenansatz unterstützen möchten. Häufig abgefragte Daten können in geeigneten Szenarien schneller bereitgestellt werden, sodass Anwendungen reaktionsschneller arbeiten und Benutzeranfragen effizienter verarbeitet werden können. Gerade bei geschäftskritischen Anwendungen kann ein strukturierter Datenzugriff entscheidend sein. Wenn Systeme regelmäßig auf Datenbanken, Webservices oder andere Backend-Quellen zugreifen müssen, kann ein Data-Grid-Ansatz helfen, wiederkehrende Zugriffe besser zu organisieren. Unternehmen erhalten dadurch eine bessere Grundlage, um Performance-Anforderungen kontrollierter zu planen und bestehende Anwendungen gezielt zu unterstützen. Verteilte Datenhaltung für moderne Enterprise-Architekturen Red Hat Data Grid unterstützt verteilte Datenstrukturen und kann in passenden Umgebungen dazu beitragen, Daten über mehrere Knoten hinweg bereitzustellen. Dadurch eignet sich die Lösung für Unternehmen, die skalierbare Anwendungen betreiben und Datenzugriffe nicht nur lokal, sondern über moderne Plattform- und Cluster-Architekturen hinweg organisieren möchten. In wachsenden IT-Landschaften ist es wichtig, Datenzugriffe nachvollziehbar und flexibel zu gestalten. Anwendungen, Services und Plattformen müssen oft schnell auf Informationen zugreifen können, ohne dass zentrale Backend-Systeme unnötig belastet werden. Red Hat Data Grid bietet hierfür eine professionelle Grundlage, um Datenzugriffe, Caching-Strategien und verteilte Anwendungsprozesse besser miteinander zu verbinden. Für Anwendungen, Plattformen und hybride Umgebungen Red Hat Data Grid kann in unterschiedlichen Unternehmensumgebungen relevant sein. Dazu gehören klassische Java-Anwendungen, moderne Plattformarchitekturen, containerisierte Workloads oder hybride IT-Landschaften. Die genaue technische Umsetzung hängt vom jeweiligen Red Hat Subskriptionsmodell, der vorhandenen Infrastruktur und dem geplanten Einsatzbereich ab. Besonders in Verbindung mit Red Hat OpenShift und modernen Plattformstrategien kann Data Grid eine wichtige Rolle spielen, wenn Anwendungen performante Datenzugriffe benötigen. Unternehmen können damit eine zusätzliche Ebene für schnelle Datenbereitstellung, Caching und verteilte Datenprozesse einplanen, ohne ihre gesamte Anwendungsarchitektur sofort grundlegend verändern zu müssen. Mehr Struktur für Performance- und Caching-Szenarien Red Hat Data Grid eignet sich für Szenarien, in denen Daten häufig genutzt, schnell abgefragt oder über mehrere Anwendungsteile hinweg verfügbar gemacht werden sollen. Unternehmen können damit eine strukturierte Grundlage schaffen, um Caching-Strategien, Datenzugriffe und Performance-Anforderungen besser zu planen. In-Memory-Datenzugriff: Geeignet für Anwendungen, die häufig benötigte Daten besonders schnell abrufen sollen. Verteilte Datenstrukturen: Unterstützt Szenarien, in denen Daten über mehrere Knoten oder Plattformbereiche hinweg organisiert werden müssen. Performance-Optimierung: Eine passende Grundlage, um Anwendungen mit hohen Anforderungen an Reaktionszeit und Datenzugriff besser zu unterstützen. Enterprise-Integration: Kann in bestehende Anwendungs-, Middleware- und Plattformstrategien eingeordnet werden. Geeignet für datenintensive Unternehmensanwendungen Red Hat Data Grid ist besonders interessant für Unternehmen, die geschä...31114,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Jarmul, Katharine: Data Privacy in der PraxisData Privacy in der Praxis , Datenschutz und Sicherheit in Daten- und KI-Projekten , Sport-Gewindefahrwerk > Sportfederung , Erscheinungsjahr: 20240627, Titel der Reihe: Animals##, Autoren: Jarmul, Katharine, Übersetzung: Fraaß, Marcus, Seitenzahl/Blattzahl: 411, Keyword: CCPA; California Consumer Privacy Act; ChatGPT; DSGVO; Data Governance; Data Mesh; Datenschutz-Grundverordnung; Deep Fakes; Differential Privacy; Föderales Lernen; Homomorphe Verschlüsselung; Privacy Engineering; Sicherheit; anonyme Daten, Fachschema: Data Mining (EDV), Fachkategorie: Computernetzwerke und maschinelle Kommunikation, Warengruppe: HC/Datenkommunikation/Netze/Mailboxen, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 235, Breite: 163, Höhe: 26, Gewicht: 770, Produktform: Kartoniert,49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
VyprVPN oder Perfect Privacy?
Beide VPN-Dienste, VyprVPN und Perfect Privacy, bieten eine sichere und anonyme Internetverbindung. VyprVPN ist bekannt für seine hohe Geschwindigkeit und Benutzerfreundlichkeit, während Perfect Privacy für seine starke Verschlüsselung und Datenschutzrichtlinien bekannt ist. Die Wahl zwischen den beiden hängt von den individuellen Bedürfnissen ab, wie z.B. ob man mehr Wert auf Geschwindigkeit oder Datenschutz legt. Es empfiehlt sich, die Funktionen und Preise beider Anbieter zu vergleichen, um die beste Entscheidung zu treffen. **
-
Welche Funktion haben die Privacy Extensions in IPv6?
Die Privacy Extensions in IPv6 dienen dazu, die Privatsphäre der Nutzer zu schützen, indem sie die Identifikation und Verfolgung von Geräten erschweren. Sie ermöglichen es, dass sich die IPv6-Adresse eines Geräts regelmäßig ändert, um die Zuordnung zu einer bestimmten Person oder einem bestimmten Gerät zu erschweren. Dies hilft, die Privatsphäre der Nutzer zu wahren und ihre Online-Aktivitäten vor unerwünschter Überwachung zu schützen. **
-
Was ist der Unterschied zwischen Big Data und Smart Data?
Big Data bezieht sich auf große Mengen von Daten, die aus verschiedenen Quellen stammen und oft unstrukturiert sind. Smart Data hingegen bezieht sich auf die Analyse und Nutzung dieser Daten, um wertvolle Erkenntnisse und Handlungsempfehlungen zu generieren. Smart Data konzentriert sich auf die Auswahl und Verarbeitung relevanter Daten, um konkrete Probleme zu lösen oder Entscheidungen zu unterstützen. **
-
Was bedeuten Data Science und Data Engineering?
Data Science bezieht sich auf die Analyse und Interpretation von Daten, um Erkenntnisse und Muster zu gewinnen, die bei der Lösung von Problemen und der Unterstützung von Entscheidungsprozessen helfen. Data Engineering hingegen bezieht sich auf die Entwicklung und Verwaltung von Dateninfrastrukturen, um sicherzustellen, dass Daten effizient erfasst, gespeichert, verarbeitet und analysiert werden können. Data Engineering legt den Fokus auf die technische Seite der Datenverarbeitung, während Data Science sich auf die Analyse und Interpretation der Daten konzentriert. **

Wo ist der Data Plug?
Wo ist der Data Plug? Kannst du mir bitte mehr Informationen darüber geben, wo ich den Data Plug finden kann? Ich bin nicht sicher, wo ich danach suchen soll. Hast du eine genaue Beschreibung oder Hinweise, die mir helfen könnten, ihn zu lokalisieren? Ich bin bereit, zu helfen, aber ich brauche mehr Details, um den Data Plug zu finden. **
Was ist der Ordner "data"?
Der Ordner "data" ist ein Verzeichnis, das dazu dient, Daten zu speichern. In diesem Ordner können verschiedene Arten von Daten abgelegt werden, wie zum Beispiel Textdateien, Bilder, Videos oder andere Dateiformate. Der genaue Inhalt des Ordners hängt von der spezifischen Anwendung oder dem Betriebssystem ab, auf dem er verwendet wird. **
Top-Angebote
Produkte zum Begriff Data-Privacy-in-der:
-
Data Privacy in der Praxis, Fachbücher von Katharine JarmulBewährte Praktiken zur Verbesserung von Privacy für Daten aus technischer, organisatorischer und rechtlicher Sicht Wie sorge ich dafür, dass die Daten in meinem Projekt privat, anonymisiert und sicher sind? Auf den europäischen Markt zugeschnitten, behandelt auch die DSGVO eingehend. Inkl. Themen wie ChatGPT und Deep Fakes. Katharine Jarmul ist eine renommierte Privacy-Spezialistin, sie arbeitet für Thoughtworks und ist Mitgründerin der PyLadies. Noch nie war der Druck, Datenschutz zu gewährleisten, so gross wie heute. Die Integration von Privacy in Datensysteme ist jedoch nach wie vor komplex. Dieser Leitfaden vermittelt Data Scientists und Data Engineers ein grundlegendes Verständnis von modernen Datenschutzbausteinen wie Differential Privacy, föderalem Lernen und homomorpher Verschlüsselung. Er bietet fundierte Ratschläge und Best Practices für den Einsatz bahnbrechender Technologien zur Verbesserung des Datenschutzes in Produktivsystemen. Privacy-Spezialistin Katharine Jarmul zeigt in diesem Buch, welche Auswirkungen die DSGVO und der California Consumer Privacy Act (CCPA) auf Ihre Data-Science-Projekte haben. Sie erklärt, wie Daten anonymisiert werden, welche Datenschutztechniken für Ihre Projekte geeignet sind und wie Sie sie integrieren. Sie erfahren ausserdem, wie Sie einen Plan für Ihr Datenprojekt erstellen, der Datenschutz und Sicherheit von Anfang an berücksichtigt. Katharine Jarmul verbindet dabei eine fundierte technische Perspektive mit leicht verständlichen Übersichten über die neuesten technologischen Ansätze und Architekturen.49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Tarnung in der Natur - Tierisches VersteckspielEntdecken Sie Die Faszinierende Welt Der Tarnung In Der Natur Mit Unserem Einzigartigen Wandkalender 'tierisches Versteckspiel'! Monat Für Monat Enthüllen 12 Atemberaubende Motive, Wie Sich Tiere Meisterhaft In Ihrer Umgebung Verbergen - Ein Wahres...19,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was bedeutet "Edu Video Privacy" in der App Prezi?
"Edu Video Privacy" ist eine Funktion in der App Prezi, die es Benutzern ermöglicht, die Privatsphäre ihrer Videos zu schützen. Mit dieser Funktion können Benutzer ihre Videos auf privat setzen, sodass sie nur von ausgewählten Personen angesehen werden können. Dadurch wird sichergestellt, dass die Inhalte nur für den vorgesehenen Zweck verwendet werden und nicht öffentlich zugänglich sind. **
-
Wie wird "privacy" ausgesprochen?
"Privacy" wird auf Englisch wie "pry-vuh-see" ausgesprochen. **
-
VyprVPN oder Perfect Privacy?
Beide VPN-Dienste, VyprVPN und Perfect Privacy, bieten eine sichere und anonyme Internetverbindung. VyprVPN ist bekannt für seine hohe Geschwindigkeit und Benutzerfreundlichkeit, während Perfect Privacy für seine starke Verschlüsselung und Datenschutzrichtlinien bekannt ist. Die Wahl zwischen den beiden hängt von den individuellen Bedürfnissen ab, wie z.B. ob man mehr Wert auf Geschwindigkeit oder Datenschutz legt. Es empfiehlt sich, die Funktionen und Preise beider Anbieter zu vergleichen, um die beste Entscheidung zu treffen. **
-
Welche Funktion haben die Privacy Extensions in IPv6?
Die Privacy Extensions in IPv6 dienen dazu, die Privatsphäre der Nutzer zu schützen, indem sie die Identifikation und Verfolgung von Geräten erschweren. Sie ermöglichen es, dass sich die IPv6-Adresse eines Geräts regelmäßig ändert, um die Zuordnung zu einer bestimmten Person oder einem bestimmten Gerät zu erschweren. Dies hilft, die Privatsphäre der Nutzer zu wahren und ihre Online-Aktivitäten vor unerwünschter Überwachung zu schützen. **
Ähnliche Suchbegriffe für Data-Privacy-in-der
-
Red Hat Data GridRed Hat Data Grid – In-Memory-Datenspeicher für schnelle und skalierbare Anwendungen Red Hat Data Grid ist eine professionelle Red Hat Subskriptionslösung für Unternehmen, die Daten schneller bereitstellen, Anwendungen performanter machen und verteilte Datenzugriffe strukturierter organisieren möchten. Die Lösung eignet sich besonders für moderne Unternehmensanwendungen, bei denen häufig genutzte Daten mit möglichst geringer Latenz verfügbar sein sollen. Wenn Sie diese Lösung über unsere Plattform kaufen , erhalten Sie eine offizielle Red Hat Subskription für den vorgesehenen Nutzungsumfang. Ihre Bestellung wird über unsere sichere Zahlung verarbeitet und anschließend digital bereitgestellt. Wenn Sie weitere Red Hat Lösungen für Middleware, OpenShift, Linux, Integration oder Enterprise-Infrastruktur suchen, können Sie passende Produkte ebenfalls direkt bei uns im Shop für Red Hat kaufen . Der genaue Preis richtet sich nach dem gewählten Subskriptionsumfang, der gewünschten Laufzeit und dem konkreten Einsatzszenario. Die Lösung richtet sich an IT-Abteilungen, Entwicklungsteams, Plattformverantwortliche und Unternehmen, die datenintensive Anwendungen zuverlässiger und reaktionsschneller betreiben möchten. Red Hat Data Grid kann dabei helfen, häufig benötigte Daten näher an Anwendungen bereitzustellen und damit Zugriffe auf langsamere Backend-Systeme zu reduzieren. Dadurch eignet sich die Lösung für Szenarien, in denen Performance, Skalierbarkeit und Datenverfügbarkeit eine wichtige Rolle spielen. Schneller Zugriff auf häufig genutzte Daten Red Hat Data Grid ist für Unternehmen interessant, die ihre Anwendungen durch einen leistungsfähigen In-Memory-Datenansatz unterstützen möchten. Häufig abgefragte Daten können in geeigneten Szenarien schneller bereitgestellt werden, sodass Anwendungen reaktionsschneller arbeiten und Benutzeranfragen effizienter verarbeitet werden können. Gerade bei geschäftskritischen Anwendungen kann ein strukturierter Datenzugriff entscheidend sein. Wenn Systeme regelmäßig auf Datenbanken, Webservices oder andere Backend-Quellen zugreifen müssen, kann ein Data-Grid-Ansatz helfen, wiederkehrende Zugriffe besser zu organisieren. Unternehmen erhalten dadurch eine bessere Grundlage, um Performance-Anforderungen kontrollierter zu planen und bestehende Anwendungen gezielt zu unterstützen. Verteilte Datenhaltung für moderne Enterprise-Architekturen Red Hat Data Grid unterstützt verteilte Datenstrukturen und kann in passenden Umgebungen dazu beitragen, Daten über mehrere Knoten hinweg bereitzustellen. Dadurch eignet sich die Lösung für Unternehmen, die skalierbare Anwendungen betreiben und Datenzugriffe nicht nur lokal, sondern über moderne Plattform- und Cluster-Architekturen hinweg organisieren möchten. In wachsenden IT-Landschaften ist es wichtig, Datenzugriffe nachvollziehbar und flexibel zu gestalten. Anwendungen, Services und Plattformen müssen oft schnell auf Informationen zugreifen können, ohne dass zentrale Backend-Systeme unnötig belastet werden. Red Hat Data Grid bietet hierfür eine professionelle Grundlage, um Datenzugriffe, Caching-Strategien und verteilte Anwendungsprozesse besser miteinander zu verbinden. Für Anwendungen, Plattformen und hybride Umgebungen Red Hat Data Grid kann in unterschiedlichen Unternehmensumgebungen relevant sein. Dazu gehören klassische Java-Anwendungen, moderne Plattformarchitekturen, containerisierte Workloads oder hybride IT-Landschaften. Die genaue technische Umsetzung hängt vom jeweiligen Red Hat Subskriptionsmodell, der vorhandenen Infrastruktur und dem geplanten Einsatzbereich ab. Besonders in Verbindung mit Red Hat OpenShift und modernen Plattformstrategien kann Data Grid eine wichtige Rolle spielen, wenn Anwendungen performante Datenzugriffe benötigen. Unternehmen können damit eine zusätzliche Ebene für schnelle Datenbereitstellung, Caching und verteilte Datenprozesse einplanen, ohne ihre gesamte Anwendungsarchitektur sofort grundlegend verändern zu müssen. Mehr Struktur für Performance- und Caching-Szenarien Red Hat Data Grid eignet sich für Szenarien, in denen Daten häufig genutzt, schnell abgefragt oder über mehrere Anwendungsteile hinweg verfügbar gemacht werden sollen. Unternehmen können damit eine strukturierte Grundlage schaffen, um Caching-Strategien, Datenzugriffe und Performance-Anforderungen besser zu planen. In-Memory-Datenzugriff: Geeignet für Anwendungen, die häufig benötigte Daten besonders schnell abrufen sollen. Verteilte Datenstrukturen: Unterstützt Szenarien, in denen Daten über mehrere Knoten oder Plattformbereiche hinweg organisiert werden müssen. Performance-Optimierung: Eine passende Grundlage, um Anwendungen mit hohen Anforderungen an Reaktionszeit und Datenzugriff besser zu unterstützen. Enterprise-Integration: Kann in bestehende Anwendungs-, Middleware- und Plattformstrategien eingeordnet werden. Geeignet für datenintensive Unternehmensanwendungen Red Hat Data Grid ist besonders interessant für Unternehmen, die geschä...31114,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Jarmul, Katharine: Data Privacy in der PraxisData Privacy in der Praxis , Datenschutz und Sicherheit in Daten- und KI-Projekten , Sport-Gewindefahrwerk > Sportfederung , Erscheinungsjahr: 20240627, Titel der Reihe: Animals##, Autoren: Jarmul, Katharine, Übersetzung: Fraaß, Marcus, Seitenzahl/Blattzahl: 411, Keyword: CCPA; California Consumer Privacy Act; ChatGPT; DSGVO; Data Governance; Data Mesh; Datenschutz-Grundverordnung; Deep Fakes; Differential Privacy; Föderales Lernen; Homomorphe Verschlüsselung; Privacy Engineering; Sicherheit; anonyme Daten, Fachschema: Data Mining (EDV), Fachkategorie: Computernetzwerke und maschinelle Kommunikation, Warengruppe: HC/Datenkommunikation/Netze/Mailboxen, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 235, Breite: 163, Höhe: 26, Gewicht: 770, Produktform: Kartoniert,49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Havlik, Laurin: Täuschung und IrreführungTäuschung und Irreführung , Das Verhältnis der individuellen und kollektiven Rechtsdurchsetzung bei irreführender Werbung gegenüber Verbrauchern , Tagfahrleuchten > Beleuchtung , Auflage: 1. Auflage, Erscheinungsjahr: 20240813, Produktform: Leinen, Titel der Reihe: Schriften zum Wirtschaftsrecht#355#, Autoren: Havlik, Laurin, Auflage: 24001, Auflage/Ausgabe: 1. Auflage, Seitenzahl/Blattzahl: 491, Themenüberschrift: LAW / Consumer, Keyword: Arglistige Täuschung; ESG; Geschäftliche Handlung; Greenwashing; Individualrechtsschutz; Lauterkeitsrecht; UGP-Richtlinie; Verbraucherschutz; Vermögensschaden; Vertragsrecht, Fachschema: Unternehmensrecht~Vertragsrecht~Verbraucherschutz - Verbraucherrecht, Fachkategorie: Vertragsrecht~Verbraucherschutzrecht, Warengruppe: HC/Handels- und Wirtschaftsrecht, Arbeitsrecht, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 234, Breite: 161, Höhe: 31, Gewicht: 842, Produktform: Gebunden, Genre: Sozialwissenschaften/Recht/Wirtschaft,119,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Red Hat Data GridRed Hat Data Grid – In-Memory-Datenspeicher für schnelle und skalierbare Anwendungen Red Hat Data Grid ist eine professionelle Red Hat Subskriptionslösung für Unternehmen, die Daten schneller bereitstellen, Anwendungen performanter machen und verteilte Datenzugriffe strukturierter organisieren möchten. Die Lösung eignet sich besonders für moderne Unternehmensanwendungen, bei denen häufig genutzte Daten mit möglichst geringer Latenz verfügbar sein sollen. Wenn Sie diese Lösung über unsere Plattform kaufen , erhalten Sie eine offizielle Red Hat Subskription für den vorgesehenen Nutzungsumfang. Ihre Bestellung wird über unsere sichere Zahlung verarbeitet und anschließend digital bereitgestellt. Wenn Sie weitere Red Hat Lösungen für Middleware, OpenShift, Linux, Integration oder Enterprise-Infrastruktur suchen, können Sie passende Produkte ebenfalls direkt bei uns im Shop für Red Hat kaufen . Der genaue Preis richtet sich nach dem gewählten Subskriptionsumfang, der gewünschten Laufzeit und dem konkreten Einsatzszenario. Die Lösung richtet sich an IT-Abteilungen, Entwicklungsteams, Plattformverantwortliche und Unternehmen, die datenintensive Anwendungen zuverlässiger und reaktionsschneller betreiben möchten. Red Hat Data Grid kann dabei helfen, häufig benötigte Daten näher an Anwendungen bereitzustellen und damit Zugriffe auf langsamere Backend-Systeme zu reduzieren. Dadurch eignet sich die Lösung für Szenarien, in denen Performance, Skalierbarkeit und Datenverfügbarkeit eine wichtige Rolle spielen. Schneller Zugriff auf häufig genutzte Daten Red Hat Data Grid ist für Unternehmen interessant, die ihre Anwendungen durch einen leistungsfähigen In-Memory-Datenansatz unterstützen möchten. Häufig abgefragte Daten können in geeigneten Szenarien schneller bereitgestellt werden, sodass Anwendungen reaktionsschneller arbeiten und Benutzeranfragen effizienter verarbeitet werden können. Gerade bei geschäftskritischen Anwendungen kann ein strukturierter Datenzugriff entscheidend sein. Wenn Systeme regelmäßig auf Datenbanken, Webservices oder andere Backend-Quellen zugreifen müssen, kann ein Data-Grid-Ansatz helfen, wiederkehrende Zugriffe besser zu organisieren. Unternehmen erhalten dadurch eine bessere Grundlage, um Performance-Anforderungen kontrollierter zu planen und bestehende Anwendungen gezielt zu unterstützen. Verteilte Datenhaltung für moderne Enterprise-Architekturen Red Hat Data Grid unterstützt verteilte Datenstrukturen und kann in passenden Umgebungen dazu beitragen, Daten über mehrere Knoten hinweg bereitzustellen. Dadurch eignet sich die Lösung für Unternehmen, die skalierbare Anwendungen betreiben und Datenzugriffe nicht nur lokal, sondern über moderne Plattform- und Cluster-Architekturen hinweg organisieren möchten. In wachsenden IT-Landschaften ist es wichtig, Datenzugriffe nachvollziehbar und flexibel zu gestalten. Anwendungen, Services und Plattformen müssen oft schnell auf Informationen zugreifen können, ohne dass zentrale Backend-Systeme unnötig belastet werden. Red Hat Data Grid bietet hierfür eine professionelle Grundlage, um Datenzugriffe, Caching-Strategien und verteilte Anwendungsprozesse besser miteinander zu verbinden. Für Anwendungen, Plattformen und hybride Umgebungen Red Hat Data Grid kann in unterschiedlichen Unternehmensumgebungen relevant sein. Dazu gehören klassische Java-Anwendungen, moderne Plattformarchitekturen, containerisierte Workloads oder hybride IT-Landschaften. Die genaue technische Umsetzung hängt vom jeweiligen Red Hat Subskriptionsmodell, der vorhandenen Infrastruktur und dem geplanten Einsatzbereich ab. Besonders in Verbindung mit Red Hat OpenShift und modernen Plattformstrategien kann Data Grid eine wichtige Rolle spielen, wenn Anwendungen performante Datenzugriffe benötigen. Unternehmen können damit eine zusätzliche Ebene für schnelle Datenbereitstellung, Caching und verteilte Datenprozesse einplanen, ohne ihre gesamte Anwendungsarchitektur sofort grundlegend verändern zu müssen. Mehr Struktur für Performance- und Caching-Szenarien Red Hat Data Grid eignet sich für Szenarien, in denen Daten häufig genutzt, schnell abgefragt oder über mehrere Anwendungsteile hinweg verfügbar gemacht werden sollen. Unternehmen können damit eine strukturierte Grundlage schaffen, um Caching-Strategien, Datenzugriffe und Performance-Anforderungen besser zu planen. In-Memory-Datenzugriff: Geeignet für Anwendungen, die häufig benötigte Daten besonders schnell abrufen sollen. Verteilte Datenstrukturen: Unterstützt Szenarien, in denen Daten über mehrere Knoten oder Plattformbereiche hinweg organisiert werden müssen. Performance-Optimierung: Eine passende Grundlage, um Anwendungen mit hohen Anforderungen an Reaktionszeit und Datenzugriff besser zu unterstützen. Enterprise-Integration: Kann in bestehende Anwendungs-, Middleware- und Plattformstrategien eingeordnet werden. Geeignet für datenintensive Unternehmensanwendungen Red Hat Data Grid ist besonders interessant für Unternehmen, die geschä...8643,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist der Unterschied zwischen Big Data und Smart Data?
Big Data bezieht sich auf große Mengen von Daten, die aus verschiedenen Quellen stammen und oft unstrukturiert sind. Smart Data hingegen bezieht sich auf die Analyse und Nutzung dieser Daten, um wertvolle Erkenntnisse und Handlungsempfehlungen zu generieren. Smart Data konzentriert sich auf die Auswahl und Verarbeitung relevanter Daten, um konkrete Probleme zu lösen oder Entscheidungen zu unterstützen. **
-
Was bedeuten Data Science und Data Engineering?
Data Science bezieht sich auf die Analyse und Interpretation von Daten, um Erkenntnisse und Muster zu gewinnen, die bei der Lösung von Problemen und der Unterstützung von Entscheidungsprozessen helfen. Data Engineering hingegen bezieht sich auf die Entwicklung und Verwaltung von Dateninfrastrukturen, um sicherzustellen, dass Daten effizient erfasst, gespeichert, verarbeitet und analysiert werden können. Data Engineering legt den Fokus auf die technische Seite der Datenverarbeitung, während Data Science sich auf die Analyse und Interpretation der Daten konzentriert. **
-
Wo ist der Data Plug?
Wo ist der Data Plug? Kannst du mir bitte mehr Informationen darüber geben, wo ich den Data Plug finden kann? Ich bin nicht sicher, wo ich danach suchen soll. Hast du eine genaue Beschreibung oder Hinweise, die mir helfen könnten, ihn zu lokalisieren? Ich bin bereit, zu helfen, aber ich brauche mehr Details, um den Data Plug zu finden. **
-
Was ist der Ordner "data"?
Der Ordner "data" ist ein Verzeichnis, das dazu dient, Daten zu speichern. In diesem Ordner können verschiedene Arten von Daten abgelegt werden, wie zum Beispiel Textdateien, Bilder, Videos oder andere Dateiformate. Der genaue Inhalt des Ordners hängt von der spezifischen Anwendung oder dem Betriebssystem ab, auf dem er verwendet wird. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.