Domain red-herring.de kaufen?
Wir ziehen mit dem Projekt
red-herring.de um.
Sind Sie am Kauf der Domain
red-herring.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain red-herring.de kaufen?
Welche Nachteile gibt es bei Big Data?
Ein Nachteil von Big Data ist die mögliche Verletzung der Privatsphäre. Durch die Sammlung und Analyse großer Datenmengen können persönliche Informationen offengelegt werden, was zu Missbrauch und Datenschutzverletzungen führen kann. Ein weiterer Nachteil ist die Komplexität der Datenanalyse, da große Datenmengen oft unstrukturiert und heterogen sind, was die Identifizierung von relevanten Informationen erschwert. Zudem besteht die Gefahr von Fehlinterpretationen und falschen Schlussfolgerungen aufgrund von Verzerrungen oder unvollständigen Daten. **
Was ist Big Data?
Big Data bezieht sich auf große Mengen an Daten, die mit hoher Geschwindigkeit und Vielfalt generiert werden. Diese Daten können aus verschiedenen Quellen stammen, wie zum Beispiel sozialen Medien, Sensoren oder Transaktionen. Big Data ermöglicht es Unternehmen, Muster und Trends zu identifizieren, um fundierte Entscheidungen zu treffen und ihre Geschäftsprozesse zu optimieren. **

Ähnliche Suchbegriffe für Big-Data-Analytik-bei-der-Vielfalt
Top-Angebote
Produkte zum Begriff Big-Data-Analytik-bei-der-Vielfalt:
-
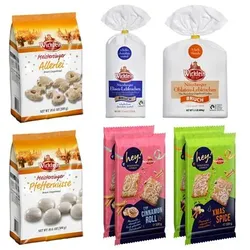
WICKLEIN Vielfalt Paket 6 versch. Sorten exklusiv bei QVC 8 Packungen, 2.100gVielfältiger Lebkuchen-Genuss WICKLEIN präsentiert eine Auswahl an köstlichen Lebkuchen- und Gebäckspezialitäten, die mit feinsten Aromen und zertifizierter Qualität begeistern. Was erhalte ich? 2 x Kekstafel Cookie Bar Cinnamon Roll – Gebäck mit Zimt, glasiert, je 100 g 2 x Kekstafel Cookie Bar Xmas Spice – Gebäck mit Gewürzen, glasiert, je 100 g Feine Nürnberger Oblaten Lebkuchen Bruch, 3-fach sortiert, 600 g Nürnberger Elisen Lebkuchen Bruch, schokoliert, 500 g Wicklein Allerlei mit Zuckerglasur (braune Lebkuchen), 300 g Wicklein Pfeffernüsse (braune Lebkuchen), 300 g Gesamtinhalt: 2.100 g Auf einen Blick traditionsreiche Lebküchnerei aus Nürnberg ausgewählte Zutaten und feine Aromen schonende Verarbeitung für besonderen Geschmack Fair-Trade-Siegel für Kakao aus 100 % fair gehandeltem Anbau enthält keinen Alkohol exklusiv bei QVC Gut zu wissen Die Produktverpackung und zugehörige Dokumente enthalten möglicherweise Angaben, die über die auf unserer Internetseite/telefonisch gemachten Angaben hinausgehen und/oder sich von ihnen unterscheiden. Bitte lies daher vor Gebrauch der Ware stets sorgfältig die Etiketten, Warnhinweise und Anleitungen, die mitgeliefert werden. Identifikationsnummer GTIN: 400835507586129,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
Feinschmecker Gemüse-VielfaltFeinschmecker Gemüse-Vielfalt nicht nur optisch sondern auch geschmacklich fünf besondere Highlights. Rotstieliger, kletternder Salat (Malabarspinat), gestreifte Rote Bete, tomatenförmige Paprika, cremig zarte Zucchini und kirschgroße, goldgelbe Physalis sorgen für selbstangebaute kulinarische Abenteuer. Tipps zum Säen, Gießen und Genießen, für eine erfolgreiche Anzucht, die weitere Pflege und den besonderen Genuss sind natürlich auch enthalten. Ernte: Zucchini: ab Mitte Juni Klettersalat, Rote Bete, Paprika: ab Mitte Juli Physalis: ab Mitte August14,24 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
Red Hat Data GridRed Hat Data Grid – In-Memory-Datenspeicher für schnelle und skalierbare Anwendungen Red Hat Data Grid ist eine professionelle Red Hat Subskriptionslösung für Unternehmen, die Daten schneller bereitstellen, Anwendungen performanter machen und verteilte Datenzugriffe strukturierter organisieren möchten. Die Lösung eignet sich besonders für moderne Unternehmensanwendungen, bei denen häufig genutzte Daten mit möglichst geringer Latenz verfügbar sein sollen. Wenn Sie diese Lösung über unsere Plattform kaufen , erhalten Sie eine offizielle Red Hat Subskription für den vorgesehenen Nutzungsumfang. Ihre Bestellung wird über unsere sichere Zahlung verarbeitet und anschließend digital bereitgestellt. Wenn Sie weitere Red Hat Lösungen für Middleware, OpenShift, Linux, Integration oder Enterprise-Infrastruktur suchen, können Sie passende Produkte ebenfalls direkt bei uns im Shop für Red Hat kaufen . Der genaue Preis richtet sich nach dem gewählten Subskriptionsumfang, der gewünschten Laufzeit und dem konkreten Einsatzszenario. Die Lösung richtet sich an IT-Abteilungen, Entwicklungsteams, Plattformverantwortliche und Unternehmen, die datenintensive Anwendungen zuverlässiger und reaktionsschneller betreiben möchten. Red Hat Data Grid kann dabei helfen, häufig benötigte Daten näher an Anwendungen bereitzustellen und damit Zugriffe auf langsamere Backend-Systeme zu reduzieren. Dadurch eignet sich die Lösung für Szenarien, in denen Performance, Skalierbarkeit und Datenverfügbarkeit eine wichtige Rolle spielen. Schneller Zugriff auf häufig genutzte Daten Red Hat Data Grid ist für Unternehmen interessant, die ihre Anwendungen durch einen leistungsfähigen In-Memory-Datenansatz unterstützen möchten. Häufig abgefragte Daten können in geeigneten Szenarien schneller bereitgestellt werden, sodass Anwendungen reaktionsschneller arbeiten und Benutzeranfragen effizienter verarbeitet werden können. Gerade bei geschäftskritischen Anwendungen kann ein strukturierter Datenzugriff entscheidend sein. Wenn Systeme regelmäßig auf Datenbanken, Webservices oder andere Backend-Quellen zugreifen müssen, kann ein Data-Grid-Ansatz helfen, wiederkehrende Zugriffe besser zu organisieren. Unternehmen erhalten dadurch eine bessere Grundlage, um Performance-Anforderungen kontrollierter zu planen und bestehende Anwendungen gezielt zu unterstützen. Verteilte Datenhaltung für moderne Enterprise-Architekturen Red Hat Data Grid unterstützt verteilte Datenstrukturen und kann in passenden Umgebungen dazu beitragen, Daten über mehrere Knoten hinweg bereitzustellen. Dadurch eignet sich die Lösung für Unternehmen, die skalierbare Anwendungen betreiben und Datenzugriffe nicht nur lokal, sondern über moderne Plattform- und Cluster-Architekturen hinweg organisieren möchten. In wachsenden IT-Landschaften ist es wichtig, Datenzugriffe nachvollziehbar und flexibel zu gestalten. Anwendungen, Services und Plattformen müssen oft schnell auf Informationen zugreifen können, ohne dass zentrale Backend-Systeme unnötig belastet werden. Red Hat Data Grid bietet hierfür eine professionelle Grundlage, um Datenzugriffe, Caching-Strategien und verteilte Anwendungsprozesse besser miteinander zu verbinden. Für Anwendungen, Plattformen und hybride Umgebungen Red Hat Data Grid kann in unterschiedlichen Unternehmensumgebungen relevant sein. Dazu gehören klassische Java-Anwendungen, moderne Plattformarchitekturen, containerisierte Workloads oder hybride IT-Landschaften. Die genaue technische Umsetzung hängt vom jeweiligen Red Hat Subskriptionsmodell, der vorhandenen Infrastruktur und dem geplanten Einsatzbereich ab. Besonders in Verbindung mit Red Hat OpenShift und modernen Plattformstrategien kann Data Grid eine wichtige Rolle spielen, wenn Anwendungen performante Datenzugriffe benötigen. Unternehmen können damit eine zusätzliche Ebene für schnelle Datenbereitstellung, Caching und verteilte Datenprozesse einplanen, ohne ihre gesamte Anwendungsarchitektur sofort grundlegend verändern zu müssen. Mehr Struktur für Performance- und Caching-Szenarien Red Hat Data Grid eignet sich für Szenarien, in denen Daten häufig genutzt, schnell abgefragt oder über mehrere Anwendungsteile hinweg verfügbar gemacht werden sollen. Unternehmen können damit eine strukturierte Grundlage schaffen, um Caching-Strategien, Datenzugriffe und Performance-Anforderungen besser zu planen. In-Memory-Datenzugriff: Geeignet für Anwendungen, die häufig benötigte Daten besonders schnell abrufen sollen. Verteilte Datenstrukturen: Unterstützt Szenarien, in denen Daten über mehrere Knoten oder Plattformbereiche hinweg organisiert werden müssen. Performance-Optimierung: Eine passende Grundlage, um Anwendungen mit hohen Anforderungen an Reaktionszeit und Datenzugriff besser zu unterstützen. Enterprise-Integration: Kann in bestehende Anwendungs-, Middleware- und Plattformstrategien eingeordnet werden. Geeignet für datenintensive Unternehmensanwendungen Red Hat Data Grid ist besonders interessant für Unternehmen, die geschä...8643,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie entsteht Big Data?
Big Data entsteht durch die Sammlung und Speicherung einer großen Menge von Daten aus verschiedenen Quellen wie Sensoren, Social Media, Transaktionen und mehr. Diese Daten werden dann mithilfe von speziellen Tools und Technologien analysiert und verarbeitet, um Muster, Trends und Erkenntnisse zu identifizieren. Durch die kontinuierliche Erfassung und Analyse von Daten in Echtzeit können Unternehmen fundierte Entscheidungen treffen und ihre Geschäftsprozesse optimieren. Letztendlich ermöglicht Big Data eine tiefere Einblicke in das Verhalten von Kunden, Trends auf dem Markt und ermöglicht die Entwicklung innovativer Produkte und Dienstleistungen. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
-
Was ist der Unterschied zwischen Big Data und Smart Data?
Big Data bezieht sich auf große Mengen von Daten, die aus verschiedenen Quellen stammen und oft unstrukturiert sind. Smart Data hingegen bezieht sich auf die Analyse und Nutzung dieser Daten, um wertvolle Erkenntnisse und Handlungsempfehlungen zu generieren. Smart Data konzentriert sich auf die Auswahl und Verarbeitung relevanter Daten, um konkrete Probleme zu lösen oder Entscheidungen zu unterstützen. **
-
Was ist das Big Data?
Was ist das Big Data? Big Data bezieht sich auf die riesigen Mengen an Daten, die in unserer digitalen Welt generiert werden. Diese Daten stammen aus verschiedenen Quellen wie sozialen Medien, Sensoren, Mobilgeräten und mehr. Big Data zeichnet sich durch die 3Vs aus: Volumen, Vielfalt und Geschwindigkeit. Unternehmen nutzen Big Data, um Muster und Trends zu erkennen, fundierte Entscheidungen zu treffen und ihre Geschäftsprozesse zu optimieren. Es erfordert spezielle Tools und Technologien wie Data Mining, maschinelles Lernen und künstliche Intelligenz, um Big Data effektiv zu verarbeiten und zu analysieren. **


Wie funktioniert Big Data Analytics?
Wie funktioniert Big Data Analytics? Big Data Analytics beinhaltet die Verarbeitung und Analyse großer Mengen von Daten, um Muster, Trends und Erkenntnisse zu identifizieren. Zunächst werden die Daten gesammelt und gespeichert, dann werden sie mithilfe von speziellen Tools und Algorithmen analysiert. Durch den Einsatz von Data Mining, maschinellem Lernen und künstlicher Intelligenz können Unternehmen wertvolle Einblicke gewinnen und fundierte Entscheidungen treffen. Die Ergebnisse der Analyse können für verschiedene Anwendungen genutzt werden, wie z.B. zur Verbesserung von Produkten und Dienstleistungen, zur Optimierung von Geschäftsprozessen oder zur Vorhersage von zukünftigen Entwicklungen. **
Wo wird Big Data gespeichert?
Big Data wird in speziellen Datenbanken und Datenlagern gespeichert, die für die Verarbeitung und Analyse großer Datenmengen optimiert sind. Oft werden dafür auch Cloud-Speicherlösungen genutzt, die skalierbar sind und eine hohe Verfügbarkeit bieten. Zudem können Unternehmen ihre Big Data in eigenen Rechenzentren oder auf dedizierten Servern speichern. Ein weiterer Trend ist die Nutzung von verteilten Systemen wie Hadoop oder Spark, die es ermöglichen, große Datenmengen auf mehreren Servern zu verteilen und parallel zu verarbeiten. Letztendlich hängt die Wahl des Speicherorts für Big Data von den individuellen Anforderungen und Ressourcen eines Unternehmens ab. **
Top-Angebote
Produkte zum Begriff Big-Data-Analytik-bei-der-Vielfalt:
-
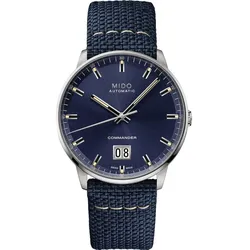
Mido Commander Big Data Herrenuhr M021.626.17.041.00Die Commander Big Date M021.626.17.041.00 von MIDO feiert das 100-jährige Jubiläum der Marke. Ihr großes Datumsfenster bei 6 Uhr bietet unübertroffene Ablesbarkeit. Das satinierte Sonnenschliff-Zifferblatt in Blau, eingefasst in ein elegantes, rundes Gehäuse aus satiniertem Edelstahl und veredelt durch eine polierte Lünette, strahlt schlichte Eleganz aus. Ausgestattet mit dem Kaliber 80, einem automatischen Uhrwerk, bietet diese Uhr eine Gangreserve von bis zu 80 Stunden. Ein transparenter Gehäuseboden und ein Textilarmband mit Kalbsleder und synthetischem Futter runden das Design ab. Großes Datumsfenster bei 6 Uhr Satinierte Sonnenschliff-Zifferblatt in Blau Automatikwerk Mido ETA Kaliber 80 Gangreserve bis zu 80 Stunden Edelstahlgehäuse mit polierter Lünette Wasserdicht bis 5 bar (50 m / 165 ft) Saphirglas Transparenter Gehäuseboden Textilarmband mit Kalbsleder und synthetisch...1020,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
WICKLEIN Vielfalt Paket 6 versch. Sorten exklusiv bei QVC 8 Packungen, 2.100gVielfältiger Lebkuchen-Genuss WICKLEIN präsentiert eine Auswahl an köstlichen Lebkuchen- und Gebäckspezialitäten, die mit feinsten Aromen und zertifizierter Qualität begeistern. Was erhalte ich? 2 x Kekstafel Cookie Bar Cinnamon Roll – Gebäck mit Zimt, glasiert, je 100 g 2 x Kekstafel Cookie Bar Xmas Spice – Gebäck mit Gewürzen, glasiert, je 100 g Feine Nürnberger Oblaten Lebkuchen Bruch, 3-fach sortiert, 600 g Nürnberger Elisen Lebkuchen Bruch, schokoliert, 500 g Wicklein Allerlei mit Zuckerglasur (braune Lebkuchen), 300 g Wicklein Pfeffernüsse (braune Lebkuchen), 300 g Gesamtinhalt: 2.100 g Auf einen Blick traditionsreiche Lebküchnerei aus Nürnberg ausgewählte Zutaten und feine Aromen schonende Verarbeitung für besonderen Geschmack Fair-Trade-Siegel für Kakao aus 100 % fair gehandeltem Anbau enthält keinen Alkohol exklusiv bei QVC Gut zu wissen Die Produktverpackung und zugehörige Dokumente enthalten möglicherweise Angaben, die über die auf unserer Internetseite/telefonisch gemachten Angaben hinausgehen und/oder sich von ihnen unterscheiden. Bitte lies daher vor Gebrauch der Ware stets sorgfältig die Etiketten, Warnhinweise und Anleitungen, die mitgeliefert werden. Identifikationsnummer GTIN: 400835507586129,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
Welche Nachteile gibt es bei Big Data?
Ein Nachteil von Big Data ist die mögliche Verletzung der Privatsphäre. Durch die Sammlung und Analyse großer Datenmengen können persönliche Informationen offengelegt werden, was zu Missbrauch und Datenschutzverletzungen führen kann. Ein weiterer Nachteil ist die Komplexität der Datenanalyse, da große Datenmengen oft unstrukturiert und heterogen sind, was die Identifizierung von relevanten Informationen erschwert. Zudem besteht die Gefahr von Fehlinterpretationen und falschen Schlussfolgerungen aufgrund von Verzerrungen oder unvollständigen Daten. **
-
Was ist Big Data?
Big Data bezieht sich auf große Mengen an Daten, die mit hoher Geschwindigkeit und Vielfalt generiert werden. Diese Daten können aus verschiedenen Quellen stammen, wie zum Beispiel sozialen Medien, Sensoren oder Transaktionen. Big Data ermöglicht es Unternehmen, Muster und Trends zu identifizieren, um fundierte Entscheidungen zu treffen und ihre Geschäftsprozesse zu optimieren. **
-
Wie entsteht Big Data?
Big Data entsteht durch die Sammlung und Speicherung einer großen Menge von Daten aus verschiedenen Quellen wie Sensoren, Social Media, Transaktionen und mehr. Diese Daten werden dann mithilfe von speziellen Tools und Technologien analysiert und verarbeitet, um Muster, Trends und Erkenntnisse zu identifizieren. Durch die kontinuierliche Erfassung und Analyse von Daten in Echtzeit können Unternehmen fundierte Entscheidungen treffen und ihre Geschäftsprozesse optimieren. Letztendlich ermöglicht Big Data eine tiefere Einblicke in das Verhalten von Kunden, Trends auf dem Markt und ermöglicht die Entwicklung innovativer Produkte und Dienstleistungen. **
-
Wie funktioniert Big Data?
Wie funktioniert Big Data? **
Ähnliche Suchbegriffe für Big-Data-Analytik-bei-der-Vielfalt
-
Feinschmecker Gemüse-VielfaltFeinschmecker Gemüse-Vielfalt nicht nur optisch sondern auch geschmacklich fünf besondere Highlights. Rotstieliger, kletternder Salat (Malabarspinat), gestreifte Rote Bete, tomatenförmige Paprika, cremig zarte Zucchini und kirschgroße, goldgelbe Physalis sorgen für selbstangebaute kulinarische Abenteuer. Tipps zum Säen, Gießen und Genießen, für eine erfolgreiche Anzucht, die weitere Pflege und den besonderen Genuss sind natürlich auch enthalten. Ernte: Zucchini: ab Mitte Juni Klettersalat, Rote Bete, Paprika: ab Mitte Juli Physalis: ab Mitte August14,24 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
Red Hat Data GridRed Hat Data Grid – In-Memory-Datenspeicher für schnelle und skalierbare Anwendungen Red Hat Data Grid ist eine professionelle Red Hat Subskriptionslösung für Unternehmen, die Daten schneller bereitstellen, Anwendungen performanter machen und verteilte Datenzugriffe strukturierter organisieren möchten. Die Lösung eignet sich besonders für moderne Unternehmensanwendungen, bei denen häufig genutzte Daten mit möglichst geringer Latenz verfügbar sein sollen. Wenn Sie diese Lösung über unsere Plattform kaufen , erhalten Sie eine offizielle Red Hat Subskription für den vorgesehenen Nutzungsumfang. Ihre Bestellung wird über unsere sichere Zahlung verarbeitet und anschließend digital bereitgestellt. Wenn Sie weitere Red Hat Lösungen für Middleware, OpenShift, Linux, Integration oder Enterprise-Infrastruktur suchen, können Sie passende Produkte ebenfalls direkt bei uns im Shop für Red Hat kaufen . Der genaue Preis richtet sich nach dem gewählten Subskriptionsumfang, der gewünschten Laufzeit und dem konkreten Einsatzszenario. Die Lösung richtet sich an IT-Abteilungen, Entwicklungsteams, Plattformverantwortliche und Unternehmen, die datenintensive Anwendungen zuverlässiger und reaktionsschneller betreiben möchten. Red Hat Data Grid kann dabei helfen, häufig benötigte Daten näher an Anwendungen bereitzustellen und damit Zugriffe auf langsamere Backend-Systeme zu reduzieren. Dadurch eignet sich die Lösung für Szenarien, in denen Performance, Skalierbarkeit und Datenverfügbarkeit eine wichtige Rolle spielen. Schneller Zugriff auf häufig genutzte Daten Red Hat Data Grid ist für Unternehmen interessant, die ihre Anwendungen durch einen leistungsfähigen In-Memory-Datenansatz unterstützen möchten. Häufig abgefragte Daten können in geeigneten Szenarien schneller bereitgestellt werden, sodass Anwendungen reaktionsschneller arbeiten und Benutzeranfragen effizienter verarbeitet werden können. Gerade bei geschäftskritischen Anwendungen kann ein strukturierter Datenzugriff entscheidend sein. Wenn Systeme regelmäßig auf Datenbanken, Webservices oder andere Backend-Quellen zugreifen müssen, kann ein Data-Grid-Ansatz helfen, wiederkehrende Zugriffe besser zu organisieren. Unternehmen erhalten dadurch eine bessere Grundlage, um Performance-Anforderungen kontrollierter zu planen und bestehende Anwendungen gezielt zu unterstützen. Verteilte Datenhaltung für moderne Enterprise-Architekturen Red Hat Data Grid unterstützt verteilte Datenstrukturen und kann in passenden Umgebungen dazu beitragen, Daten über mehrere Knoten hinweg bereitzustellen. Dadurch eignet sich die Lösung für Unternehmen, die skalierbare Anwendungen betreiben und Datenzugriffe nicht nur lokal, sondern über moderne Plattform- und Cluster-Architekturen hinweg organisieren möchten. In wachsenden IT-Landschaften ist es wichtig, Datenzugriffe nachvollziehbar und flexibel zu gestalten. Anwendungen, Services und Plattformen müssen oft schnell auf Informationen zugreifen können, ohne dass zentrale Backend-Systeme unnötig belastet werden. Red Hat Data Grid bietet hierfür eine professionelle Grundlage, um Datenzugriffe, Caching-Strategien und verteilte Anwendungsprozesse besser miteinander zu verbinden. Für Anwendungen, Plattformen und hybride Umgebungen Red Hat Data Grid kann in unterschiedlichen Unternehmensumgebungen relevant sein. Dazu gehören klassische Java-Anwendungen, moderne Plattformarchitekturen, containerisierte Workloads oder hybride IT-Landschaften. Die genaue technische Umsetzung hängt vom jeweiligen Red Hat Subskriptionsmodell, der vorhandenen Infrastruktur und dem geplanten Einsatzbereich ab. Besonders in Verbindung mit Red Hat OpenShift und modernen Plattformstrategien kann Data Grid eine wichtige Rolle spielen, wenn Anwendungen performante Datenzugriffe benötigen. Unternehmen können damit eine zusätzliche Ebene für schnelle Datenbereitstellung, Caching und verteilte Datenprozesse einplanen, ohne ihre gesamte Anwendungsarchitektur sofort grundlegend verändern zu müssen. Mehr Struktur für Performance- und Caching-Szenarien Red Hat Data Grid eignet sich für Szenarien, in denen Daten häufig genutzt, schnell abgefragt oder über mehrere Anwendungsteile hinweg verfügbar gemacht werden sollen. Unternehmen können damit eine strukturierte Grundlage schaffen, um Caching-Strategien, Datenzugriffe und Performance-Anforderungen besser zu planen. In-Memory-Datenzugriff: Geeignet für Anwendungen, die häufig benötigte Daten besonders schnell abrufen sollen. Verteilte Datenstrukturen: Unterstützt Szenarien, in denen Daten über mehrere Knoten oder Plattformbereiche hinweg organisiert werden müssen. Performance-Optimierung: Eine passende Grundlage, um Anwendungen mit hohen Anforderungen an Reaktionszeit und Datenzugriff besser zu unterstützen. Enterprise-Integration: Kann in bestehende Anwendungs-, Middleware- und Plattformstrategien eingeordnet werden. Geeignet für datenintensive Unternehmensanwendungen Red Hat Data Grid ist besonders interessant für Unternehmen, die geschä...8643,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Schwedt, Georg: Taschenatlas der AnalytikTaschenatlas der Analytik , Der Taschenatlas bietet eine kompakte Einführung und Übersicht über Grundlagen und Anwendungen der Analytischen Chemie. Dabei sind jeweils erläuternder Text und eine Farbtafel auf einer Doppelseite gegenübergestellt. Das Buch enthält insgesamt 125 Farbtafeln, die die gesamte Breite der modernen Analytik in Chemie, Biowissenschaften und Teilen von Physik und Materialwissenschaften abdecken. Für die vierte Auflage wurde der Taschenatlas erweitert und auf den aktuellen Stand gebracht. Er enthält u. a. acht neue Farbtafeln zu aktuellen Themen wie Mikroextraktionstechniken, Radioimmunoassays, Superfluid-Chromatographie und die elektronenmikroskopische Untersuchung von Materialoberflächen. Mit diesem Atlas sind die Grundlagen aller wichtigen analytischen Verfahren immer griffbereit - ideal zum raschen Nachlesen und für die Prüfungsvorbereitung. , Kupplungszüge > Sport-Getriebe , Auflage: 4. aktualisierte und ergänzte Auflage, Erscheinungsjahr: 20230215, Produktform: Kartoniert, Autoren: Schwedt, Georg, Illustrator: Schreiber, Joachim, Auflage: 23004, Auflage/Ausgabe: 4. aktualisierte und ergänzte Auflage, Seitenzahl/Blattzahl: 265, Abbildungen: 125 farbige Abbildungen, Themenüberschrift: SCIENCE / Chemistry / Analytic, Keyword: Analytische Chemie; Chemie; Chemie / Allgemeines, Lexika; Chemische Analyse; Materialwissenschaften; Umweltanalytik; Werkstoffprüfung, Fachschema: Chemie~Chemie / Analytisch, Fachkategorie: Maschinenbau und Werkstoffe, Bildungszweck: für die Hochschule, Warengruppe: HC/Chemie, Fachkategorie: Analytische Chemie, Thema: Verstehen, Text Sprache: ger, Seitenanzahl: X, Seitenanzahl: 265, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Wiley-VCH GmbH, Verlag: Wiley-VCH GmbH, Verlag: Wiley-VCH, Länge: 218, Breite: 142, Höhe: 17, Gewicht: 401, Produktform: Kartoniert, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Vorgänger EAN: 9783527317295 9783527308705 9783137593027 9783137593010, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0010, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,44,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Foucault, Michel: Analytik der MachtAnalytik der Macht , Die Frage nach der Macht durchzieht nicht nur wie ein roter Faden das Werk Michel Foucaults, sondern war auch Anlaß zu höchst kontroversen Diskussionen, die keineswegs abgeschlossen sind - im Gegenteil: Foucaults Konzepte, wie etwa die Biomacht, die Gouvernementalität, aber auch die Ästhetik der Existenz oder die Disziplinarmacht, geben aktuellen Debatten in der Philosophie und Soziologie, aber auch der Politik- und Geschichtswissenschaft entscheidende Impulse. Dieser Band versammelt die wichtigsten Texte Foucaults und bietet somit einen umfassenden Überblick über einen der zentralen Bereiche der Theoriebildung der letzten Jahrzehnte. In seinem Nachwort erschließt Thomas Lemke sowohl den historischen als auch den systematischen Kontext von Foucaults Machttheorie. , Mehrschichtlacke > Autolackierbedarf , Auflage: Neuauflage, Erscheinungsjahr: 201105, Produktform: Kartoniert, Titel der Reihe: suhrkamp taschenbücher wissenschaft#1759#, Autoren: Foucault, Michel, Redaktion: Defert, Daniel~Bischoff, Michael~Ewald, Francois, Übersetzung: Ansén, Reiner~Gondek, Hans-Dieter~Kocyba, Hermann~Schröder, Jürgen, Auflage/Ausgabe: Neuauflage, Seitenzahl/Blattzahl: 349, Keyword: Aufsatzsammlung; Diskursanalyse; Macht; STW 1759; STW1759; suhrkamp taschenbuch wissenschaft 1759, Fachschema: Geschichte / Kulturgeschichte~Kulturgeschichte~Macht~Mächtig~Philosophie / Gesellschaft, Politik, Staat~Soziologie / Theorie, Philosophie, Anthropologie, Fachkategorie: Politikwissenschaft~Sozial- und Kulturgeschichte~Moderne Philosophie: nach 1800~Soziale und politische Philosophie, Region: Frankreich, Warengruppe: TB/Philosophie/20./21. Jahrhundert, Fachkategorie: Sozialtheorie, Thema: Verstehen, Text Sprache: ger, Originalsprache: fre, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Suhrkamp Verlag AG, Verlag: Suhrkamp Verlag AG, Verlag: Suhrkamp, Länge: 177, Breite: 111, Höhe: 20, Gewicht: 213, Produktform: Kartoniert, Genre: Geisteswissenschaften/Kunst/Musik, Genre: Geisteswissenschaften/Kunst/Musik, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Kennzeichnung von Titeln mit einer Relevanz > 30, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0012, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Lagerartikel, Unterkatalog: Taschenbuch,25,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist der Unterschied zwischen Big Data und Smart Data?
Big Data bezieht sich auf große Mengen von Daten, die aus verschiedenen Quellen stammen und oft unstrukturiert sind. Smart Data hingegen bezieht sich auf die Analyse und Nutzung dieser Daten, um wertvolle Erkenntnisse und Handlungsempfehlungen zu generieren. Smart Data konzentriert sich auf die Auswahl und Verarbeitung relevanter Daten, um konkrete Probleme zu lösen oder Entscheidungen zu unterstützen. **
-
Was ist das Big Data?
Was ist das Big Data? Big Data bezieht sich auf die riesigen Mengen an Daten, die in unserer digitalen Welt generiert werden. Diese Daten stammen aus verschiedenen Quellen wie sozialen Medien, Sensoren, Mobilgeräten und mehr. Big Data zeichnet sich durch die 3Vs aus: Volumen, Vielfalt und Geschwindigkeit. Unternehmen nutzen Big Data, um Muster und Trends zu erkennen, fundierte Entscheidungen zu treffen und ihre Geschäftsprozesse zu optimieren. Es erfordert spezielle Tools und Technologien wie Data Mining, maschinelles Lernen und künstliche Intelligenz, um Big Data effektiv zu verarbeiten und zu analysieren. **
-
Wie funktioniert Big Data Analytics?
Wie funktioniert Big Data Analytics? Big Data Analytics beinhaltet die Verarbeitung und Analyse großer Mengen von Daten, um Muster, Trends und Erkenntnisse zu identifizieren. Zunächst werden die Daten gesammelt und gespeichert, dann werden sie mithilfe von speziellen Tools und Algorithmen analysiert. Durch den Einsatz von Data Mining, maschinellem Lernen und künstlicher Intelligenz können Unternehmen wertvolle Einblicke gewinnen und fundierte Entscheidungen treffen. Die Ergebnisse der Analyse können für verschiedene Anwendungen genutzt werden, wie z.B. zur Verbesserung von Produkten und Dienstleistungen, zur Optimierung von Geschäftsprozessen oder zur Vorhersage von zukünftigen Entwicklungen. **
-
Wo wird Big Data gespeichert?
Big Data wird in speziellen Datenbanken und Datenlagern gespeichert, die für die Verarbeitung und Analyse großer Datenmengen optimiert sind. Oft werden dafür auch Cloud-Speicherlösungen genutzt, die skalierbar sind und eine hohe Verfügbarkeit bieten. Zudem können Unternehmen ihre Big Data in eigenen Rechenzentren oder auf dedizierten Servern speichern. Ein weiterer Trend ist die Nutzung von verteilten Systemen wie Hadoop oder Spark, die es ermöglichen, große Datenmengen auf mehreren Servern zu verteilen und parallel zu verarbeiten. Letztendlich hängt die Wahl des Speicherorts für Big Data von den individuellen Anforderungen und Ressourcen eines Unternehmens ab. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.